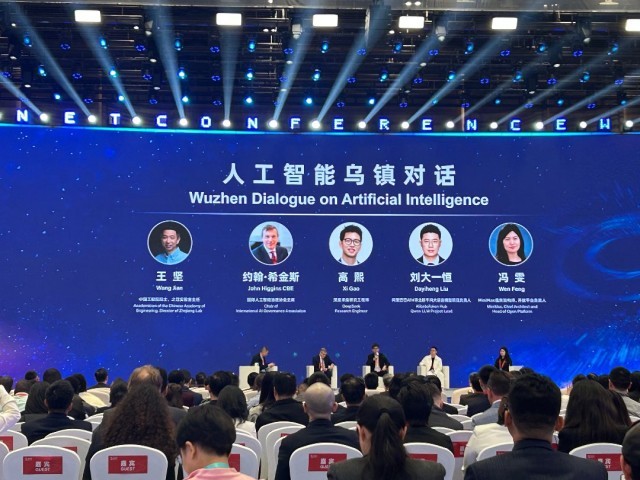
11月3日,2026年世界互联网大会乌镇峰会主论坛举行。在论坛“人工智能乌镇对话”环节,国际人工智能治理协会主席约翰·希金斯,深度求索(DeepSeek)研究工程师高熙,阿里巴巴ATH事业群千问大语言模型项目负责人刘大一恒,MiniMax首席架构师、开放平台负责人冯雯围绕“全球人工智能开放共建”展开深度对话。中青报·中青网记者 贾骥业/摄
中青报·中青网记者 贾骥业
11月3日,在2026年世界互联网大会乌镇峰会主论坛上,举行了一场“人工智能乌镇对话”,对话关键词是“开源”。
中国工程院院士、之江实验室主任王坚是这场对话环节的主持人,临开始前,他特意嘱咐同传工作人员:“当我们说‘开源人工智能’的时候,最好把全称翻译出来——Open Artificial Intelligence,不要简单翻成‘Open AI’,这像是一家公司的名字。”
王坚话音一落,现场泛起了阵阵笑声。显而易见,在场的人都知道他说的是哪家公司。也是他这句看似不起眼的澄清,让当天这场对话的逻辑更加清晰:不讨论一家公司的成败,而是整个AI行业的选择。
在近一个小时的时间中,国际人工智能治理协会主席约翰·希金斯,深度求索(DeepSeek)研究工程师高熙,阿里巴巴ATH事业群千问大语言模型项目负责人刘大一恒,MiniMax首席架构师、开放平台负责人冯雯围绕“全球人工智能开放共建”进行了深度对话,他们从为何“开源”谈到安全治理,最后把话题落到了年轻人身上。
“我们想要AGI更快到来”
开源是一种开放协作的开发模式,即程序员将代码公之于众,任何人都能免费获取、自由修改和再发布,由此形成技术共享、彼此成就的良性循环。其实,“开源”这个词很早便有,但在王坚看来,今天的开源开放跟以前不太一样。他说:“在软件时代,中国更多的是开源思想的受益者,但人工智能时代,中国变成了重要的贡献者。”
对于大模型企业说,开源意味着要把模型交出去,甚至很多都是自己最好的模型。“为什么要坚定选择开源?”这是王坚抛出的第一个问题。高熙给出的答案很简单——为了AGI(通用人工智能)。“我们想要AGI更快到来。”高熙说。
与AI相比,AGI的智能程度更高,被认为是与人类智能相当的一种智能形式,其研究发展涉及计算机科学、认知科学、心理学等多学科领域。近年来,AI技术快速发展,从简单的聊天、翻译,到深度推理,再到执行复杂任务,正向AGI一步步突破。但AGI何时才能实现,目前尚无定论。
“如果AGI本来是十几年之后到,我会希望它能加速到一年后;如果本来是一年后,那我希望它明天就能到。”高熙回忆起2023年初第一次接触ChatGPT的瞬间:与机器对话、依靠AI完成科学突破——那些过去只停留在想象中的东西,忽然有了路径。他说:“我在这个行业中感觉到,AI的发展每一年都比前一年要更快。”
在高熙看来,真正的对手不是国内外的大模型公司,而是时间。“时间才像是一个很难打败的对手,我们一定要争分夺秒将AGI带到身边。”高熙表示,从这个视角看,开源才是应对挑战的更好选择。技术创新需要公开讨论、验证和测试,如果闭源设障阻拦竞争对手,短期看可能保持领先,但放长时间看,延迟的是全社会获得技术红利的时间。
在国内,DeepSeek、阿里千问、腾讯混元都坚持走开源路径。3年多前,刘大一恒亲手完成了千问第一代7B模型的训练并开源,此后,这一系列陆陆续续开源了460多款模型,全球下载量超过40亿次。
刘大一恒认为,开源在加速创新的同时,也推动实现了去中心化、分布式的创新。他说,开源让核心技术不再只是掌握在少数企业手中,而是让全球开发者和生态共同参与创新。开源不仅是开放模型使用权,更是开放了全球每个人参与创造AI的权利。同时,世界上有很多问题可能头部公司并不关心,比如小语种、特殊垂类应用等,但有了开源,这些“最后一公里”才有人去做。
开源还可以赋能学术界,同时反哺生态,推动模型发展。刘大一恒举了个例子:世界上有不少学者,他们不缺乏想象力、创造力,缺的是算力,是可以参与大模型开发的机会和条件。“开源模式其实就为他们提供了一个很好的平台。”刘大一恒说。
关于开源,冯雯观察到,各家企业的开源路径虽各有侧重,但开源的内容早已突破模型权重的单一范畴,研发过程中的实验数据、工程改造方案等也被纳入开源范围,这些能帮助全行业减少重复试错、提速研发进程,让从业者向着AGI更快迈进。
不开源也有安全问题,但开源确实多“几道坎”
开源开放推动AI技术创新进一步提速,治理和安全问题也随之而来。王坚的第二个提问就关于安全。他说:“把模型交出去,换回来的是更快的迭代和更大的生态。但技术交到更多人手里,隐私与安全问题也无法回避。”
“我们需要信赖可靠的产品。保障开源安全,已成为全社会需要共同承担的责任。”约翰·希金斯提到了自己身边的一个案例。他的一个银行董事长朋友,对在银行内部使用开源AI感到非常担忧,因为有时候完全搞不清模型的来源背景。“如何打消客户的顾虑,这是很多人共同的疑问。”约翰·希金斯强调。
“开源模型确实比闭源模型要多出一些额外的安全问题。”刘大一恒认为,首先,开源模型具有不可撤回性,模型一旦开源就会被大量传播,如果它有问题,确实无法向闭源模型一样实时在线修复;其次,开源模型缺少外部防护屏障,它的安全性很大程度上依赖后训练内生安全能力,第三方拿到模型权重后,可以想办法绕过内置安全护栏,破坏安全约束。
刘大一恒说,开源的价值是加速AI技术扩散。模型治理,则是让技术以负责任的方式释放出来。“二者相辅相成,才能帮我们更快、更安全地实现AGI。”在他看来,安全治理仍是当下AI发展极为重要的问题,需要更多人才、更多投入——这是一个生态问题。
有人建议采用“给模型分级”的思路开展AI安全治理。比如,将AI模型分成ABC三类,能力强的“限制访问”,能力弱的“随意访问”,能力处于中间的“有条件限制访问”。刘大一恒直言这种治理方式存在缺陷。他认为,我们现在对模型能力的判断可能是被低估的,数年之后,后训练技术可能会把现在这些开源模型的潜力解锁出来。“分级治理很难从根本上解决问题。面对AI新时代,要从模型之外找办法,比如法律法规、行业规范等。”
高熙没有回避开源模型存在的安全问题,但他也坦言,模型不开源也同样有安全风险。他说,不管是文本生成类还是图像生成类大模型,本身就自带安全风险,比如来自人的恶意滥用、AI本身带来的风险等,无法完全避免。现在很多大模型企业也都在通过模型分析、限制模型开源能力等方式来解决上述问题。
但要注意的是,开源对模型安全和治理有积极作用。刘大一恒介绍,开源模型更加白盒化,会有更多学者去研究模型的安全性;现在模型的网络控制能力越来越强,未来开源模型的防御能力也会越来越强。“在很多场景下,我们可以通过部署开源模型去增强防御能力。”
冯雯在工作中就观察到,当把大模型落地到具体行业中,开源在技术自主可控方面就带来了不一样的价值。“模型开源之后,大量使用者会结合自身企业、行业场景,共同思考如何安全落地。”她强调,开源模型已成为私有化部署、打造自有模型非常好的基础底座。她认为,开源不只是把模型“交出去”,也是在把模型安全地“留下来”。
开源AI的未来在哪里
“技术本身就是在服务人类。具体到人工智能,我们的未来将如何被AI影响?”第三个问题关于开源AI的未来。
工作、教育、生活,这三个方面是刘大一恒在回答中着重提到的。
首先是工作。刘大一恒说,过去衡量一个人的生产力,看专业能力、执行力、工作经验和时间投入等;但在AI时代,如何驾驭AI、有效地组织AI工具来提升生产力,是另一项更重要的能力。“对个人来说,能不能提出更好的问题,能不能组织好AI,能不能在关键信息的抽取和判断上做得更好,这些能力会越来越值钱。”
教育是刘大一恒更愿意谈的部分。“我对AI在教育上的作用比较乐观,首先会减少教育的不平等。”他回忆到,小时候要想接受好的教育,可能得去省城找名师。现在AI改变了获取知识的方式,无论在城市还是在偏远地区,都可以用低成本触达世界上最顶尖的专家。
刘大一恒的孩子从小就对天文非常感兴趣,但要想讲好天文实际上并不容易。“有了AI,我的妻子用AI模型几句话就做出了PPT以及黑洞模拟软件,讲给孩子听,这在过去很难做到。”他说,现在的孩子很有想法和创造力,缺的是实践资源,“AI能帮他们把想象力释放出来”。
关于生活,刘大一恒认为AI更像是一次工业革命。一方面物质生活会被改善,人类有更多时间去追求梦想,了解以前好奇但没有时间了解的问题,做以前做不到的事;另一方面,大家会有更多时间和精力建立人与人之间的情感连接。
2022年底,ChatGPT(一款AI聊天机器人模型)横空出世,AI技术发展进入大模型时代。短短三四年时间,AI大模型已经从最开始的聊天,走向芯片设计、漏洞挖掘、数学求证等专业领域,解决复杂问题。从上述变化中,冯雯真切体会到了一句中国俗语:众人拾柴火焰高。
她以自己的体验为例说:“我们把模型开源之后,经常会出现意想不到的好事。芯片厂商、开发者、内容创作者都来做适配,还把自己做模型训练的工具发到开源社区中。”她判断,未来几年,大模型会在更多行业大规模落地,解决更复杂的问题。“开源让我们看到,一家公司能做的其实有限,但开源可以把边界推得更远。”冯雯说。
关于未来,约翰·希金斯更在意AI对年轻人的影响。他说,处于前沿的年轻人通常对新技术都比较感兴趣,AI的发展会影响年轻人的学习方式,塑造年轻人的心智、思维等。“当前,年轻人已经开始广泛地使用人工智能,速度非常快,这将会改变我们的社会。”
在冯雯看来,大模型压缩了智能密度、让技术更加平权,需要更有创造力和生命力的年轻人加入。“什么是AI Native(原生)的组织,什么是AI Native的产品形态——这个问题,需要真正AI Native的下一代来回答。”冯雯说。
中国青年报客户端浙江乌镇11月4日电